이동하는 데이터에 연산을 더하다.
RiDM은 센서 가까이에서 데이터를 먼저 처리하는 Runtime Programmable Dataflow Architecture, DODA를 개발합니다. 필요한 연산을 데이터 발생 지점에 가깝게 배치해 중앙 CPU/GPU로 이동하는 데이터와 처리 부담을 줄입니다.
원시 데이터 이동은 비쌉니다. 그리고 해마다 늘어납니다.
센서 하나하나가 원시 스트림을 만들고, 그 스트림은 무엇이든 유용한 일이 일어나기 전에 프로세서까지 실려 갑니다. 센서가 밀집된 시스템에서는 연산이 아니라 이 이동이 병목이 되고 있으며, 센서 수는 계속 늘고 있습니다.
이 숫자들은 지금도 커지고 있고, 센서 하나가 스트림 하나를 더합니다.
데이터 이동은 줄이고, 반응은 더 빠르게.
모든 스트림이 동시에 도착하지만, CPU는 하나씩 처리합니다.
- 반응 지연 증가 — 결과 하나마다 메모리를 네 번 오갑니다
- 프레임마다 달라지는 지연 — 각 스트림이 CPU 차례를 기다립니다
- 센서를 추가할수록 모든 센서의 지연이 악화됩니다
모든 스트림이 동시에 도착하고, 처리도 동시에 이루어집니다.
센싱 시스템의 병목은 전처리입니다. 모든 원시 데이터가 공유 메모리에 기록되고, CPU가 처리한 뒤 다시 기록되어야 비로소 가속기가 읽어갑니다. RiDM의 독자 아키텍처 DODA는 이 연산을 센서 옆에서 수행해, 융합·축약된 데이터만 시스템을 이동하도록 합니다.
- 결과까지의 경로 단축 — 메모리에 도달하기 전에 데이터를 축약
- 지연 편차 감소 — 어떤 스트림도 다른 스트림을 기다리지 않음
- 센서가 늘어도 호스트 지연을 유지하도록 설계
센서 데이터가 많은 환경부터.
Physical AI
감지·판단·구동이 하나의 제어 루프로 이어지는 임바디드 시스템으로, 인지 지연이 제어 주기를 결정하는 영역
Edge AI
상위 연산 계층으로 데이터를 전달하기 전 Filtering, Pre-processing, 선택적 Inference 처리
Robotics
다중 센서와 실시간 제어가 필요한 로보틱스 환경에서의 Sensor Fusion 처리
Sensing Systems
Sonar, UWB, Beamforming, Imaging 등 센서 가까이에서 필터링과 데이터 융합이 필요한 워크로드
Low-Latency Networking
SmartNIC, HFT, 시장 데이터 처리처럼 전송 및 처리 지연이 중요한 네트워크 워크로드
실행 중에 연산 흐름을 조율하는 데이터플로우 머신, DODA.
컴파일 시점에 정해진 순서가 아니라, 데이터가 준비된 연산부터 실행합니다. 새로운 워크로드를 위해 실리콘을 다시 만들지 않고 파이프라인을 재구성할 수 있습니다.
Dynamically Orchestrated Dataflow Architecture
오케스트레이션이 사전에 정해지지 않고 데이터가 도착하는 대로 이루어집니다. 고정된 파이프라인과 데이터플로우 머신의 차이가 바로 이 지점입니다.
박사 연구에서 특허까지.
Toward General-Purpose Dynamic Dataflow Processing
빠르면서도 효율적인 범용 데이터플로우 아키텍처를 목표로 한 이진호 대표의 NUS 박사 연구입니다.
PCT 특허 3건
핵심 아키텍처, 인터커넥트, 런타임 재구성을 포괄합니다.
- WO2023/234867Reconfigurable Computing Architecture
- WO2024/242626 A1Hierarchical Network Design for Dynamic Dataflow Style Architectures
- WO2026/015086 A1Adaptive and Reconfigurable Dataflow Computing System and Method
직접 실행해 보세요.
doda_simulation은 Verilator로 구현한 DODA 시뮬레이터입니다. 간단한 컴파일러가 코드의 lambda 함수를 캡처해 DODA에서 실행하며, 데이터플로우 그래프를 그대로 실행하는 머신인 만큼 그래프를 직접 입력할 수도 있습니다. 예제 그래프도 함께 제공됩니다.
https://github.com/gino-comp/doda_simulation
EdgeFuse
DODA 기반 실시간 멀티센서 전처리
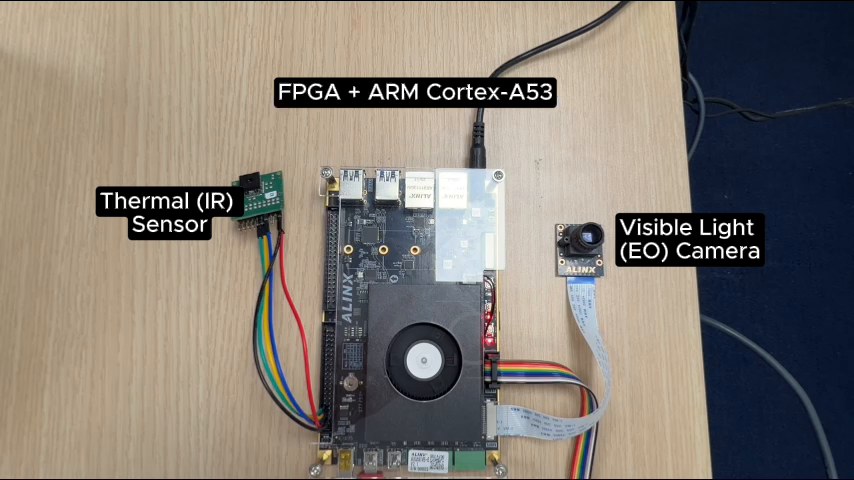
가시광 카메라와 열화상 센서가 FPGA에 연결되고, FPGA 위의 DODA 프로토타입이 두 스트림을 동기화·융합한 뒤에야 애플리케이션 CPU에 전달합니다. 프레임 동기화와 적응형 뷰 전환을 CPU 단독 처리와 나란히 비교합니다.
- FPGA 위 칼만 필터 기반 센서 융합
- 렌즈 왜곡 보정을 위한 EO/IR 기하학적 교정
- 목표: CPU 단독 기준선 대비 약 100× 가속
팀 이진호 · Tingting Xiang · Burin Amornpaisannonhttps://www.ridm.tech/ko/lab-notes/edgefuse/
엣지 디바이스의 멀티모달 센싱, 점점 복잡해진다
로봇과 같은 엣지 디바이스에서 멀티모달 센싱은 이미 표준이 되어가고 있습니다. 가시광 카메라와 열화상 센서 두 개만 써도 이미지 리사이즈에 CPU가 버거워집니다. 프레임이 도착하는 속도를 CPU가 따라가지 못하면서 두 스트림은 점점 어긋납니다.
여기에 LiDAR, 레이더, SAR까지 더해지면 어떻게 될까요? 센서가 늘어날수록 전처리 부담은 선형이 아닌 방식으로 커집니다. 이것은 튜닝으로 해결할 수 있는 문제가 아닙니다.
DODA로 전처리를 센서 바로 옆으로
원시 프레임을 CPU로 보내는 대신, FPGA 패브릭에 DODA 오버레이를 배치해 센서와 애플리케이션 코어 사이에 둡니다. 가시광 카메라(45 FPS, 1280×960)와 열화상 센서(9 FPS, 160×120)에서 픽셀이 도착하는 즉시 DODA가 리사이즈와 시간 정렬을 처리합니다. ARM 코어에는 이미 동기화된 스트림 하나만 전달됩니다.
마지막 픽셀이 도착하는 순간 전처리가 완료됩니다 — CPU 단독 기준선 대비 전처리 19× 가속.
프레임 동기화
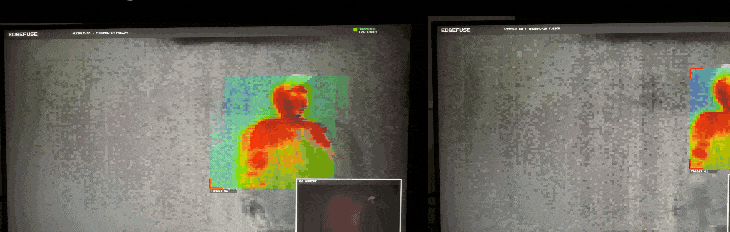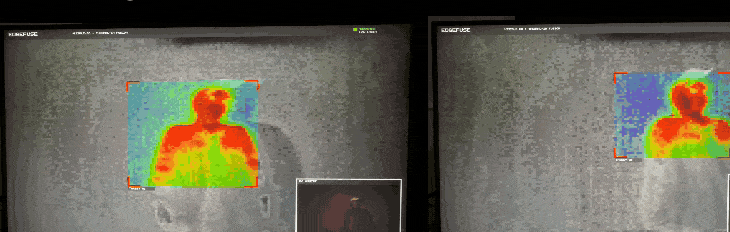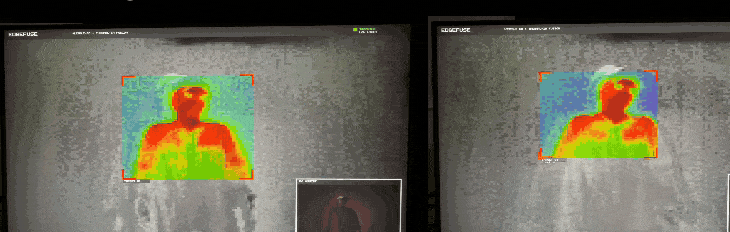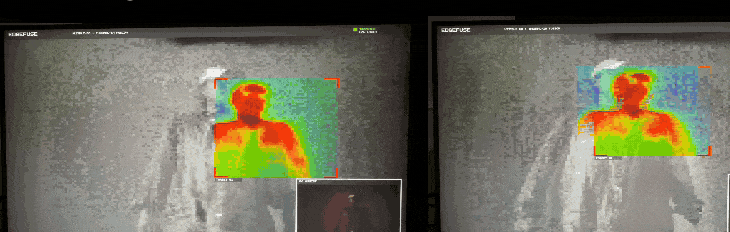
같은 하드웨어에서 나란히 비교합니다. CPU 단독 처리(왼쪽)에서는 가시광과 열화상 프레임이 어긋나 열화상 오버레이가 사람의 실제 위치에서 벗어납니다. DODA 전처리(오른쪽)에서는 두 스트림이 단단히 고정됩니다.
적응형 뷰 전환
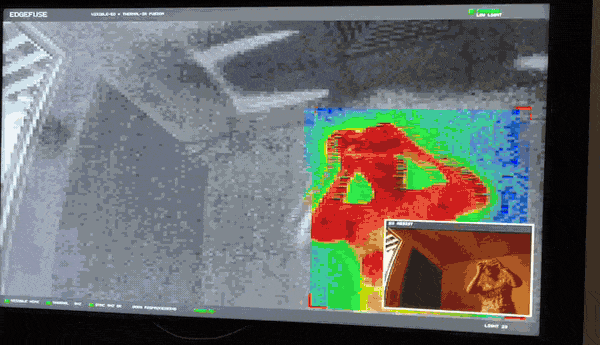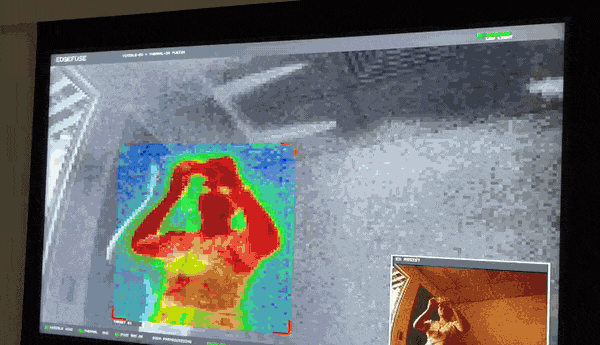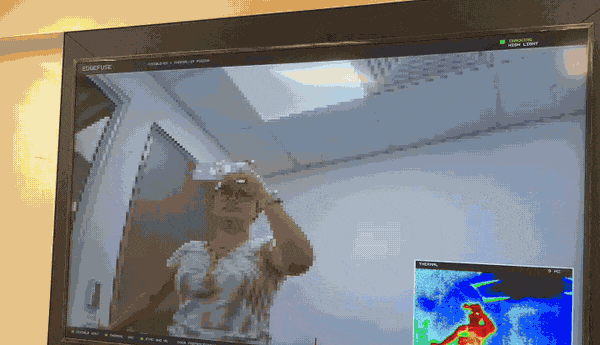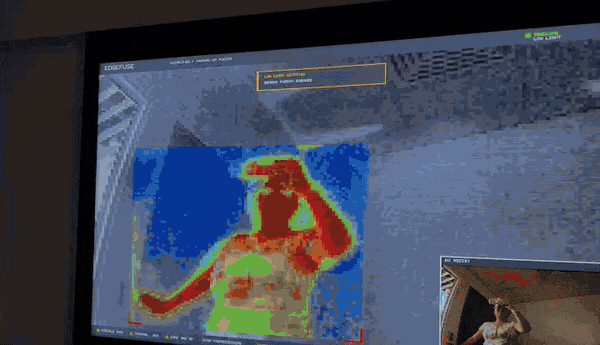
동기화에 더해, EdgeFuse는 주변 밝기에 따라 EO와 IR의 융합 가중치를 연속적으로 조정합니다. 고정된 임계값 없이, 조명이 변하는 대로 블렌드가 부드럽게 이동합니다. 빛이 충분하면 가시광 뷰가 주를 이루고 열화상이 PIP로 표시되고, 빛이 줄어들면 융합된 열화상 뷰가 전면에, 가시광이 PIP로 바뀝니다.
전환은 즉각적입니다. FPGA에서 센서 가까이 판단이 이루어지기 때문에 애플리케이션은 이미 전환된 스트림을 추가 지연 없이 받습니다.
하드웨어
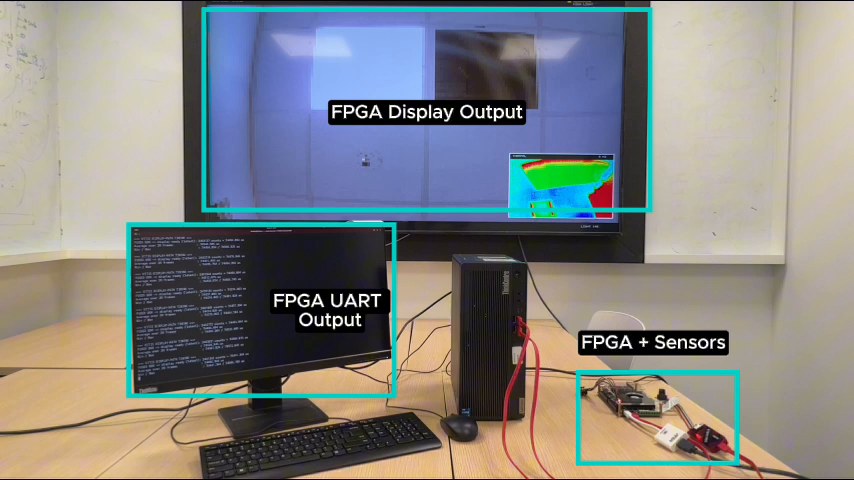
모든 것이 ARM Cortex-A53이 탑재된 FPGA SoC 보드 한 장에서 동작합니다. 열화상(IR) 센서와 가시광(EO) 카메라는 보드에 직접 연결되며, DODA 프로토타입은 FPGA 패브릭에, 애플리케이션은 A53에서 실행됩니다.
다음 단계
이 프로토타입은 촉박한 일정 속에서 완성되었습니다. 현재의 19× 가속은 시작에 불과합니다. 두 가지 근접 목표:
- FPGA 위의 DODA 오퍼레이터로 구현하는 칼만 필터 기반 센서 융합.
- CPU 도달 전에 렌즈 왜곡을 보정하는 EO/IR 기하학적 교정.
- 두 개선이 완료될 경우 CPU 단독 기준선 대비 약 100× 가속 예상.
RiDM을 만드는 사람들.
General-purpose Dynamic Dataflow Processing, Reconfigurable Computer Architecture
싱가포르RiDM PTE. LTD.
핵심 IP 개발- Tingting XiangCTO & Co-founder · NUS PhD Candidate
- Xiaoqing (Serena) Xie, MBACFO & Co-founder · NUS MBA
- Trevor E. Carlson, PhDCo-founder · Advisor · Associate Professor, NUS
한국RiDM Korea
실리콘 구현 및 사업 개발- 문정현IC Designer · 경희대학교
- 정규현RTL Design Engineer · 연세대학교
연구실에서 회사로.
NUS GRIP 졸업
NUS의 대표 딥테크 창업 인큐베이션 프로그램인 NUS GRIP(현 National GRIP)을 성공적으로 졸업했습니다.
시드 투자 유치
Qube Research & Technologies와 The Invention Lab으로부터 시드 라운드 투자를 유치했습니다.
RiDM Korea 설립 · TIPS 선정
자회사 RiDM Korea를 설립하고 TIPS R&D 과제에 선정되었습니다.
새로운 소식과 연구 업데이트
- CompanyRiDM Korea 설립 및 TIPS 과제 선정
- ResearchISCA 2026 논문 게재
- Funding시드 투자 유치
- IPAdaptive and Reconfigurable Dataflow Computing System and Method
- IPHierarchical Network Design for Dynamic Dataflow Style Architectures
- CompanyNUS GRIP 수료
- IPReconfigurable Computing Architecture
RiDM과 협업을 논의해보세요.
기술 검토, 라이선스, 공동개발, 연구 협력 등 어떤 형태의 협업도 환영합니다. 생각하고 계신 내용을 편하게 알려주세요.